A IA Que Mente Com Convicção
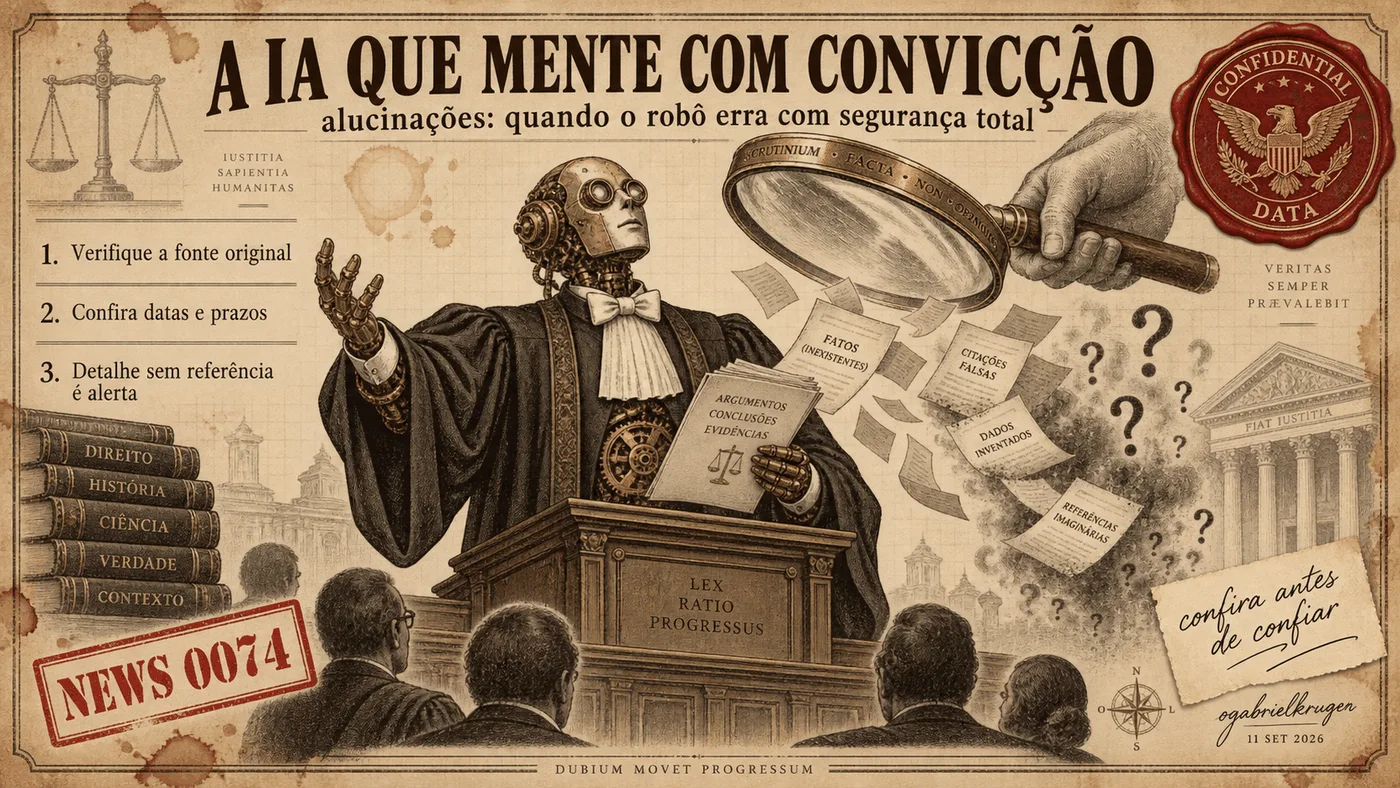
Stanford colocou modelos de IA à prova em mais de 800 mil questões jurídicas reais: 58% das respostas continham erros fabricados com a mesma confiança das corretas. Pior: pedir para o modelo se autocorrigir não funciona, e até as ferramentas jurídicas pagas, vendidas como livres de alucinação, erram em 17% a 33% dos casos.
Existe um tipo de erro que assusta mais que o erro grosseiro: o erro bem escrito. Em janeiro de 2024, pesquisadores do Stanford RegLab e do HAI publicaram o estudo Large Legal Fictions, que submeteu modelos de linguagem de uso geral a mais de 800 mil questões jurídicas verificáveis [1] [3]. O resultado: as taxas de alucinação variaram de 58% a 88% dependendo do modelo, com o GPT-4 errando 58% do tempo, o GPT-3.5, 69%, e o Llama 2, 88% [3]. Não eram respostas vagas ou incompletas. Eram decisões citadas com número de processo, nome de relator e tese central, tudo estatisticamente perfeito e factualmente inventado. O ponto que costuma passar batido nesses números é que a alucinação não é um bug de versão, é uma propriedade da arquitetura. Um modelo de linguagem gera o texto mais provável, não o mais verdadeiro. Quando ele escreve 'REsp 1.234.567, rel. Min. Fulano', está produzindo uma sequência que obedece ao formato estatístico de milhares de citações reais que viu no treinamento. A citação falsa é fluente exatamente porque a fluência é tudo que o modelo sabe produzir. Por isso o erro jurídico é tão traiçoeiro: o leitor humano valida com o mesmo critério que sempre usou, correção formal e tom confiante, e é justamente esse critério que a alucinação fraudulentamente satisfaz.
Pedir para a IA se verificar não funciona
A reação instintiva de todo time que descobre o problema é a mesma: vamos pedir para o modelo revisar a própria resposta antes de enviar. O estudo de Stanford testou exatamente isso, e o achado é desconfortável. Quando os pesquisadores deram ao modelo a oportunidade de se autocorrigir, identificando erros antes de responder, os ganhos foram marginais ou nulos [1]. O modelo que alucina uma citação não guarda, em lugar nenhum da sua memória de execução, a bandeira 'isto foi inventado'. A verificação exige acesso a uma fonte externa, algo fora do modelo. Perguntar a ele mesmo é pedir testemunho à parte interessada. A consequência prática disso é dura para quem constrói operações de IA: self-check não é controle de qualidade, é teatro de conformidade. Se o seu fluxo de trabalho tem uma etapa 'a IA confere se está tudo certo antes de subir para o cliente', essa etapa protege contra erro de formatação, talvez contra erro de cálculo simples. Não protege contra citação fabricada, número de processo inexistente ou cláusula que parece jurídica e não é.
O modelo que alucinou a resposta não é a entidade certa para auditar a resposta. Verificação de fato acontece fora do modelo, numa fonte que ele não controla. Enquanto o processo tratar 'pedir para a IA conferir' como etapa de qualidade, o processo não tem etapa de qualidade.
- Gabriel Krüger, Arquiteto de Operações com IA
A promessa que veio junto com o produto pago
A indústria respondeu ao problema com uma arquitetura específica: ferramentas jurídicas com RAG (retrieval-augmented generation), que buscam a resposta em bases documentais oficiais antes de gerar o texto. LexisNexis e Thomson Reuters passaram a divulgar seus produtos, Lexis+ AI, Westlaw AI-Assisted Research e Ask Practical Law AI, como capazes de 'eliminar' alucinações e garantir citações 'hallucination-free' [2]. Era a promessa que o mercado queria ouvir: pague a ferramenta certa e o problema desaparece. O segundo estudo de Stanford, Hallucination-Free?, publicado em versão definitiva revisada por pares em 2025, colocou essa promessa à prova com um protocolo pré-registrado, o primeiro do gênero a avaliar ferramentas jurídicas proprietárias com RAG [2]. Os resultados: Lexis+ AI e Ask Practical Law AI produziram informação incorreta em mais de 17% das consultas, e o Westlaw AI-Assisted Research alucinou em mais de 34% delas [1]. A versão com GPT-4 no mesmo benchmark errou 43% das vezes [3]. O RAG reduz o erro de forma real e substancial, mas a promessa de eliminação era, nas palavras dos próprios pesquisadores, exagero [2]. Um erro em cada seis consultas, na ferramenta mais bem avaliada, continua sendo um número que muda completamente o desenho do processo de trabalho.
Insight central
O erro da ferramenta paga é mais perigoso que o erro do chatbot gratuito, exatamente porque vem embrulhado numa promessa de validade. O time que desconfia do ChatGPT confere. O time que paga por 'hallucination-free' tende a conferir menos, e é aí que o modo como você compra tecnologia determina o modo como você erra.
O que acontece quando ninguém confere
Isso não é exercício teórico. O caso mais citado é o do advogado nova-iorquino sancionado por citar casos inventados pelo ChatGPT em petição judicial, mas ele é apenas o primeiro de uma série [1]. No Brasil, o tema deixou de ser curiosidade acadêmica: há sanção aplicada pelo TJSC e ofícios circulares da OAB orientando sobre o uso de IA em peças processuais [6]. Ou seja, o risco migrou do plano técnico para o plano profissional e disciplinar. Quem cola resposta de IA sem verificação hoje não está mais correndo risco de retrabalho, está correndo risco de sanção. E o problema não é exclusividade do Direito. O Direito é apenas o domínio onde a alucinação é mais fácil de detectar, porque existe um processo, um número e uma base oficial contra os quais conferir. Levantamentos recentes apontam taxas de alucinação de até 15% em respostas de modelos de linguagem em geral, com recomendações convergentes de verificar fontes, datas e afirmações antes de confiar no conteúdo [5]. Em domínios sem número de processo, a citação falsa circula por mais tempo antes de ser pega: o nome de um concorrente num comparativo, uma estatística num post de vendas, uma data numa proposta comercial.
Arquitetura importa: fechado vence aberto
Quando a comparação é entre arquiteturas, e não entre marcas, o padrão é consistente. Ferramentas de corpus fechado, que só respondem com base em documentos fornecidos e citam o trecho de origem, erram bem menos que modelos generalistas respondendo de memória: uma diferença de 13% contra 40% em avaliação com documentos jurídicos [4]. No melhor cenário, resumo de documento fornecido na própria pergunta, as taxas caem para algo entre 3% e 14% dependendo do modelo [4]. A lição de engenharia é direta: quanto mais o modelo responde a partir de uma fonte amarrada na sua frente, menos espaço ele tem para inventar. Quanto mais ele responde de memória, mais a ficção se disfarça de pesquisa.
Protocolo de verificação para qualquer operação que usa IA:
- Nome próprio, número, citação ou data que sai de IA é dado não verificado até bater contra a fonte original. Sem exceção por confiança no modelo.
- Self-check do modelo não conta como verificação. A checagem acontece fora dele, num link clicável, numa base oficial, num documento que existia antes da pergunta.
- Ferramenta paga com RAG reduz erro, não elimina. 17% significa um erro a cada seis consultas na melhor das ferramentas testadas.
- Prefira arquiteturas de corpus fechado, onde a resposta vem ancorada num trecho citável do documento de origem, sempre que a tarefa permitir.
- Separe tarefas de rascunho (IA escreve, humano confere tudo) de tarefas de fato (IA só com fonte amarrada, e ainda assim com amostragem de auditoria).
- Registre a fonte de cada claim em material que vai para cliente. Se a fonte é 'a IA disse', o material não está pronto.
A IA não mente porque quebrou, mente porque funcionar é isso aí: gerar a sequência mais convincente. A pergunta certa nunca foi 'a IA está confiável', e sim 'qual processo meu detecta a mentira antes que ela chegue ao cliente'.
- Gabriel Krüger, Arquiteto de Operações com IA
O estudo de Stanford não é um argumento contra IA em operações profissionais, é um argumento contra a distribuição de confiança que a maioria das empresas fez nos últimos dois anos. A IA redige, pesquisa, resume e estrutura melhor que qualquer ferramenta que já tivemos. O que ela não faz, e nenhuma arquitetura atual promete honestamente fazer, é carregar dentro de si a certeza sobre o que é verdade. Essa parte do processo continua sendo sua. E quanto mais automático o resto do fluxo se torna, mais valiosa, e mais rara, é a etapa humana que abre o link e confere.
Referências
- [1]AI on Trial: Legal Models Hallucinate in 1 out of 6 (or More) Benchmarking Queries (Stanford HAI)
- [2]Hallucination-Free? Assessing the Reliability of Leading AI Legal Research Tools (Stanford RegLab)
- [3]What the Science Says About Hallucinations in Legal Research (AI Law Librarians)
- [4]Legal GenAI tools mislead 17% of time: Stanford study (Legal Dive)
- [5]IA alucina em até 15% das respostas, diz estudo. Como identificar uma falsa resposta? (Exame)
- [6]Alucinação de Inteligência Artificial em Peças Processuais: Achados do Stanford RegLab, a Sanção do TJSC e os Ofícios à OAB (Douglas Vilar)
Gostou desta edição?
Assine a newsletter e receba análises densas sobre IA, gestão e produtividade todo dia no WhatsApp.
Sem spam. Saia do grupo quando quiser.