Quarenta Mil Papers Por Mês: Quando a IA Afoga a Ciência
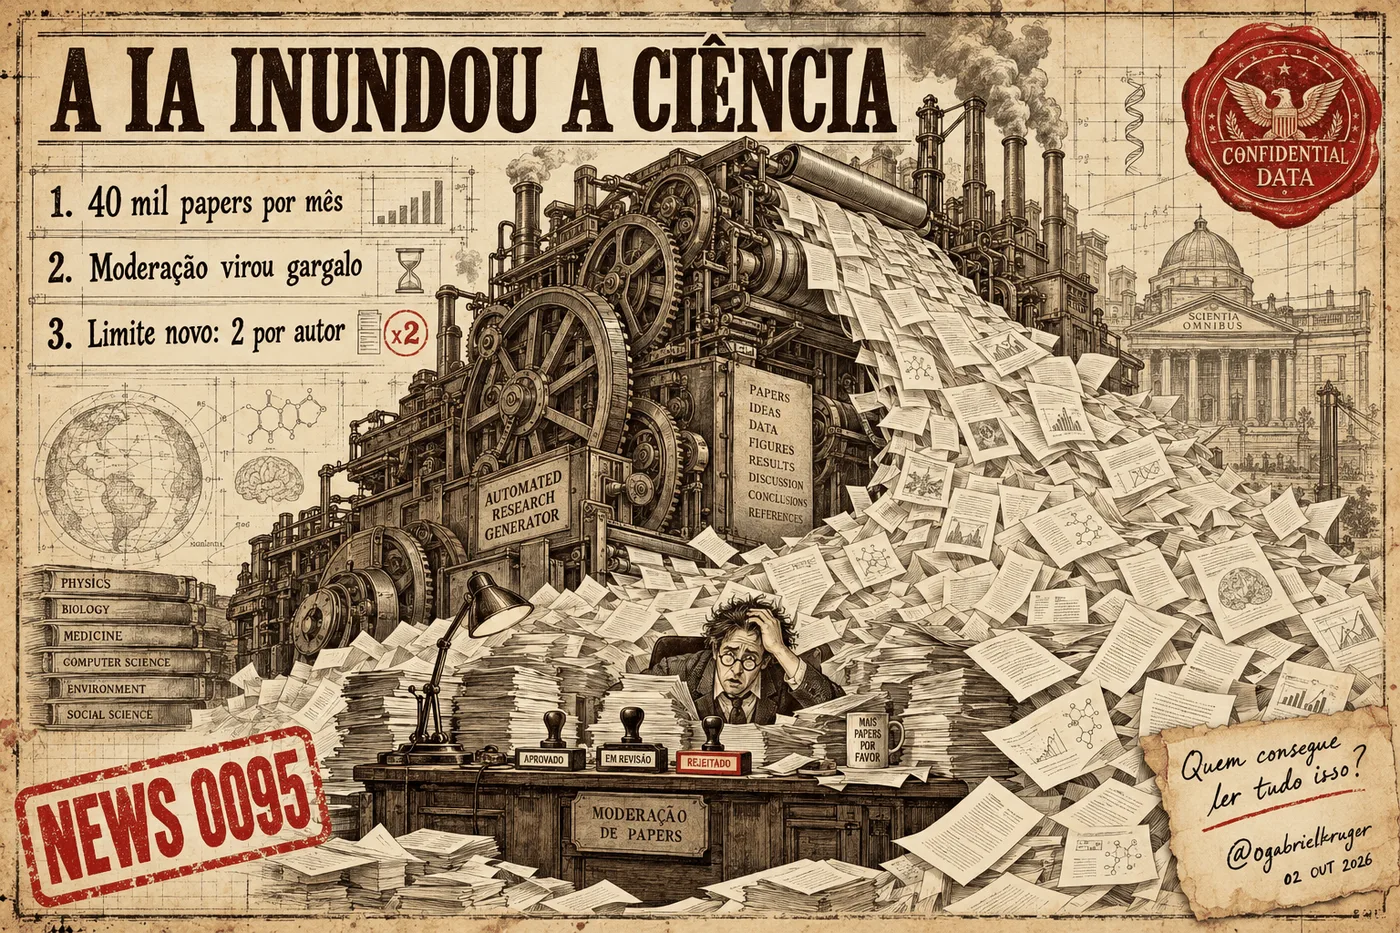
O maior arquivo científico do mundo bateu recorde de 40 mil submissões em um único mês e reagiu do único jeito que restava: limitou cada autor a dois papers. A decisão expõe o ponto exato em que gerar conteúdo ficou trivial e avaliar conteúdo virou o gargalo.
Em setembro de 2026, o arXiv recebeu 40.363 submissões em um único mês, recorde absoluto dos 35 anos do arquivo [1]. Não foi um pico isolado de uma categoria específica: foi o mês em que a infraestrutura voluntária que sustenta a ciência aberta desde 1991 admitiu, oficialmente, que não dá mais conta. Na quinta-feira seguinte ao recorde, 1º de outubro, o servidor que guarda praticamente toda a física, matemática e ciência da computação de fronteira publicou um comunicado enxuto: a partir dali, cada autor pode submeter apenas dois papers por mês [1]. A era em que publicar mais era sinal de produtividade acabou de bater no teto, e o teto é humano.
A regra nova é simples e dura: no máximo duas submissões por mês calendário e no máximo três submissões ativas ao mesmo tempo, valendo para todas as categorias, não só para ciência da computação [1]. E o detalhe que muda tudo: submissão rejeitada conta na cota. O limite é sobre o ato de submeter, não sobre o paper anunciado, porque é a submissão que consome o tempo do moderador [1]. O próprio arXiv classifica a medida como uma solução provisória (um stopgap, no texto original) enquanto decide o que vira boa prática de publicação numa era em que qualquer pessoa consegue gerar um paper plausível em minutos [1].
O número que quebrou o arXiv
A trajetória é inequívoca. Setembro de 2016: 9.869 submissões. Setembro de 2024: 20.569. Setembro de 2026: 40.363, o dobro de dois anos antes, acompanhado de quase 9.000 tickets de suporte gerados para a equipe e os moderadores [1]. Na categoria cs.AI, especificamente, o volume cresceu mais de seis vezes em dois anos, enquanto as demais categorias dobraram no mesmo período [1]. Do outro lado do balcão, o trabalho de checagem continua sendo feito majoritariamente por voluntários lendo submissão por submissão, do jeito que sempre foi. A análise interna do servidor mostrou autores submetendo dezenas de papers, cada um consumindo uma fatia de tempo de checagem que não se multiplica [4]. O custo de gerar texto desabou; o custo de julgar texto continua o mesmo.
Insight central
Geração de conteúdo escala com IA; julgamento de conteúdo não escala com nada. Qualquer sistema, um servidor de preprints, um time de marketing, uma caixa de entrada, que deixa entrar mais do que consegue avaliar está comprando volume ao preço da confiança.
Salami science e a regra de um strike
O que os moderadores reportam ver mais não é fraude escancarada, é a degradação silenciosa da unidade de trabalho científico: papers finos de escopo estreito, salami papers (um único estudo fatiado em vários artigos menores) e um aumento marcante de textos densos escritos por IA [1]. Vale dizer: a política do arXiv permite IA como ferramenta de apoio à pesquisa, desde que o uso seja declarado e o resultado atenda aos padrões de relevância científica [1]. O problema nunca foi a ferramenta, é o volume de material que chega sem carregar substância nenhuma.
A escalada vinha de antes. Em maio de 2026, o arXiv anunciou a regra de um strike: autor que submeter paper com evidência inequívoca de geração alucinada por LLM (referências que não existem, citações inventadas, instruções do modelo esquecidas no meio do texto) toma suspensão de um ano e, ao voltar, precisa apresentar trabalhos aprovados em revisão por pares antes de publicar de novo [2][3]. Na mesma linha, artigos de revisão e position papers em ciência da computação passaram a exigir aceitação prévia em venue revisada antes de entrar no arXiv [3]. O limite de duas submissões é o terceiro degrau dessa escada: se o filtro não consegue avaliar tudo, ele limita a entrada.
Uma proporção relativamente pequena de autores está submetendo um grande número de papers de baixa qualidade e consumindo uma fração desproporcional do tempo dos moderadores. Isso é injusto com os autores que continuam submetendo trabalho de qualidade, que podem ter seus papers atrasados por dias ou semanas.
- Thomas G. Dietterich, presidente do Conselho Editorial Consultivo do arXiv [1]
Nem todo mundo aplaudiu. O pesquisador de IA Nathan Lambert defende o caminho oposto: aceitar quase qualquer pesquisa de ciência da computação e resolver qualidade depois, porque, segundo ele, a direção atual é o começo de uma morte lenta do arXiv, com a exigência de revisão por pares alcançando também os papers técnicos em dois ou três anos [3]. Lambert observa que, sob as regras atuais, ele próprio não poderia ter publicado no arXiv o PDF do seu livro sobre RLHF, leitura pedida pela área inteira [3]. Os efeitos colaterais já têm dono: laboratório que precisa registrar prioridade sobre um resultado agora raciona quais dois trabalhos do mês sobem; paper rejeitado por erro de formato queima um terço da cota; e submissões paradas na fila de moderação continuam contando no limite de três ativas, ou seja, o próprio gargalo que a política tenta resolver pode travar o autor de publicar qualquer coisa nova [1][3].
A lição que vale fora da academia
O arXiv não quebrou porque a IA escreve mal. Quebrou porque a IA amplificou um comportamento que sempre existiu (publicar muito para parecer produtivo) num ritmo que o processo de filtragem, humano e voluntário, não acompanha. A tese vale para qualquer operação: IA não substitui processo, ela multiplica o que já existe. Time que já produzia relatório raso com pressa agora produz quarenta relatórios rasos por mês; operação que já publicava post genérico agora enche o calendário editorial de peças que ninguém lê até o fim. Quando o custo de produzir cai a zero, o gargalo migra para o único recurso que não cai de preço: a atenção de quem lê. E atenção não se compra em doses industriais, se conquista por unidade de trabalho.
Antes de publicar algo gerado com IA neste mês:
- Passe no teste do leitor atento: uma pessoa qualificada lê até o fim e sai com valor novo? Se a resposta é não, não publique.
- Consolide em vez de fatiar: se três rascunhos contam a mesma história, é um trabalho só. Salami paper é desperdício nos dois lados do balcão [1].
- Verifique cada referência e cada número citado. Referência alucinada é o gatilho explícito de banimento de um ano no arXiv, e o critério está virando regra em outras plataformas [2].
- Declare o uso de IA quando a plataforma, o cliente ou a empresa exigirem. Transparência é o que separa assistência de fraude na política oficial do arXiv [1].
- Meça o que é lido, não o que é publicado. Volume de saída sem leitor é custo puro disfarçado de produtividade.
A IA não quebrou a ciência. Ela só expôs, em escala industrial, uma verdade antiga: publicar nunca foi o produto. O produto sempre foi a atenção de quem lê, e essa não escala.
- Gabriel Krüger, Arquiteto de Operações com IA
Referências
Gostou desta edição?
Assine a newsletter e receba análises densas sobre IA, gestão e produtividade todo dia no WhatsApp.
Sem spam. Saia do grupo quando quiser.